🚀 开始使用
📋 API 配置指南
VideoLingo 使用大模型进行翻译,TTS 仅在配音时需要。服务商和模型由用户自行选择。
1. 大模型的 API_KEY:
在侧栏设置 API 地址、密钥和模型。客户端使用兼容 OpenAI 的 Chat Completions, 多个步骤需要结构化 JSON。选择接口实际支持的模型,参数量本身不能证明翻译质量 或 JSON 可靠性。仅在服务支持时开启 JSON 模式。
推荐使用 OpenLux (opens in a new tab) 中转,API 地址填 https://api.openlux.ai/v1。模型可按下面三档选。价格为 OpenLux 常见自动路由分组下的实测约价(美元 / 百万 token,随分组浮动):
| 建议 | 模型 ID | 输入 | 输出 |
|---|---|---|---|
| 默认,性价比高 | gpt-6-luna | $0.006 | $0.029 |
| 质量更好 | gpt-6-sol | $0.074 | $0.37 |
| 质量最好 | claude-opus-5-5 | $0.71 | $3.53 |
也可以使用其他兼容服务,例如 OpenRouter,地址填 https://openrouter.ai/api/v1,或使用本地兼容服务。即使服务不验证凭据,应用仍要求密钥字段非空,只有在服务明确忽略密钥时才使用占位值。Edge TTS 需要联网,不是离线语音合成。
2. TTS 的 API
VideoLingo提供了多种 tts 接入方式,以下是对比(如不使用配音可跳过)
| TTS 方案 | 提供商 | 优点 | 缺点 | 中文效果 | 非中文效果 |
|---|---|---|---|---|---|
| 🎙️ OpenAI TTS | OpenLux (opens in a new tab) | 情感真实 | 中文听起来像外国人 | 😕 | 🤩 |
| 🎙️ Fish Audio | Fish Audio (opens in a new tab) | 克隆视频里的声音,也可以用 fish.audio 上的任意音色 | API 需付费 | 🤩 | 😃 |
| 🎙️ SiliconFlow FishTTS | 硅基流动 (opens in a new tab) | 语音克隆 | 克隆效果不稳定 | 😃 | 😃 |
| Edge TTS | 在线服务 | 此适配器无需单独 API 密钥 | 需要联网 | — | — |
| 🗣️ GPT-SoVITS | 本地 | 最强语音克隆 | 只支持中英文,需要本地训练推理,配置麻烦 | 🏆 | 🚫 |
- SiliconFlow FishTTS 请在 硅基流动 (opens in a new tab) 获取key,注意克隆功能需要付费充值积分;
- OpenAI TTS 使用 OpenLux (opens in a new tab),和 LLM 用同一个 key 即可。其他兼容 OpenAI 语音接口的服务,可以在
config.yaml里修改openai_tts.base_url和openai_tts.model; - Fish Audio 请在 fish.audio (opens in a new tab) 获取 key。API 按用量计费,账户里需要有余额,克隆不另外收费;
- F5-TTS 仅支持 302AI (opens in a new tab),克隆视频里的声音;
自定义 TTS 适配器位于
core/tts_backend/custom_tts.py。
SiliconFlow FishTTS 使用教程
目前支持 3 种模式:
preset: 使用固定音色,可以在 官网Playground (opens in a new tab) 试听,默认anna。clone(stable):API 模式custom,按文本长度和时长限制,从任务列表选择合适的参考片段合并并上传为可复用音色,不一定是视频最初十秒。clone(dynamic):API 模式dynamic,使用当前句子的参考片段。音色一致性和质量取决于参考音频及服务,不保证比 custom 模式更好。
OpenAI 声音怎么选?
声音列表可以在 官网 (opens in a new tab) 找到,例如 alloy, echo, nova等,在 config.yaml 中修改 openai_tts.voice 即可。默认模型是 gpt-4o-mini-tts。
Fish Audio 声音怎么选?
在页面里选择服务商 Fish Audio,有两种模式:
- 视频里的声音(克隆):默认模式。取视频开头 15-30 秒的人声作为所有句子的参考,不会在你的 Fish Audio 账户里保存任何东西。请只克隆你有权使用的声音。
- 固定音色:列表里自带两个音色,
语彤和浩然。想用其他音色时,选择fish.audio 上的其他音色,在 fish.audio (opens in a new tab) 找到喜欢的音色并打开,把页面网址或 ID 粘贴进来即可。
想把喜欢的音色放进列表,在 config.yaml 的 fish_audio.voices 里添加名字和 ID。模型是 fish_audio.model,默认 s2.1-pro。
Edge TTS 声音怎么选?
Edge TTS 是默认的配音方式,不需要 API 密钥。运行 edge-tts --list-voices 可以列出所有声音,例如 zh-CN-XiaoxiaoNeural、en-US-JennyNeural,请选择目标语言的声音,在 config.yaml 的 edge_tts.voice 或侧栏中修改。
GPT-SoVITS-v2 使用教程
-
前往 官方的语雀文档 (opens in a new tab) 查看配置要求并下载整合包。
-
将
GPT-SoVITS-v2-xxx与VideoLingo放在同一个目录下。注意是两文件夹并列。 -
选择以下任一方式配置模型:
a. 自训练模型:
- 训练好模型后,
GPT-SoVITS-v2-xxx\GPT_SoVITS\configs下的tts_infer.yaml已自动填写好你的模型地址,将其复制并重命名为你喜欢的英文角色名.yaml - 在和
yaml文件同个目录下,放入后续使用的参考音,命名为你喜欢的英文角色名_参考音频的文字内容.wav或.mp3,例如Huanyuv2_你好,这是一条测试音频.wav - 在 VideoLingo 网页的侧边栏中,将
GPT-SoVITS 角色配置为你喜欢的英文角色名。
b. 使用预训练模型:
- 从 这里 (opens in a new tab) 下载我的模型,解压后覆盖到
GPT-SoVITS-v2-xxx。 - 在
GPT-SoVITS 角色配置为Huanyuv2。
c. 使用其他训练好的模型:
-
将
xxx.ckpt模型文件放在GPT_weights_v2文件夹下,将xxx.pth模型文件放在SoVITS_weights_v2文件夹下。 -
参考方法 a,重命名
tts_infer.yaml文件,并修改文件中的custom部分的t2s_weights_path和vits_weights_path指向你的模型,例如:# 示例 法 b 的配置: t2s_weights_path: GPT_weights_v2/Huanyu_v2-e10.ckpt version: v2 vits_weights_path: SoVITS_weights_v2/Huanyu_v2_e10_s150.pth -
参考方法 a,在和
yaml文件同个目录下,放入后续使用的参考音频,命名为你喜欢的英文角色名_参考音频的文字内容.wav或.mp3,例如Huanyuv2_你好,这是一条测试音频.wav,程序会自动识别并使用。 -
⚠️ 警告:请使用英文命名
角色名,否则会出现错误。参考音频的文字内容可以使用中文。目前仍处于测试版,可能产生报错。
# 期望的目录结构: . ├── VideoLingo │ └── ... └── GPT-SoVITS-v2-xxx ├── GPT_SoVITS │ └── configs │ ├── tts_infer.yaml │ ├── 你喜欢的英文角色名.yaml │ └── 你喜欢的英文角色名_参考音频的文字内容.wav ├── GPT_weights_v2 │ └── [你的GPT模型文件] └── SoVITS_weights_v2 └── [你的SoVITS模型文件] - 训练好模型后,
配置完成后,注意在网页侧边栏选择 参考音频模式(具体原理可以参考语雀文档),VideoLingo 在配音步骤时会自动在弹出的命令行中打开 GPT-SoVITS 的推理 API 端口,配音完成后可手动关闭。注意,此方法的稳定性取决于选择的底模。
🛠️ 快速上手
VideoLingo 支持 Windows、macOS(Apple Silicon / Intel)和 Linux。
让本地 AI Agent 帮你安装 🤖
如果你的 AI Agent 可以操作这台电脑,直接告诉它:
帮我安装 GitHub 上的 Huanshere/VideoLingo,并启动它。
Windows:双击安装 🎉
- 从最新版本页面 (opens in a new tab)下载 Source code (zip),解压到桌面等方便找到的位置,并打开文件夹。
- 双击
OneKeyStart.bat,保持窗口打开。首次运行会自动安装 uv、Python 3.12、应用依赖和 FFmpeg,需要联网。 - 安装完成后,VideoLingo 会自动在浏览器中打开。在侧栏填写 API 地址、密钥和模型,就可以开始使用了。
如果使用 NVIDIA 显卡,先安装兼容的驱动,详见显卡运行环境。
从源码安装(Windows、macOS、Linux)
git clone https://github.com/Huanshere/VideoLingo.git && cd VideoLingo
uv run start.py
以后在 VideoLingo 文件夹中运行 uv run start.py 即可启动。Apple Silicon 自动使用 MLX,Intel Mac 使用 CPU 识别。Intel Mac 默认配音只保留新生成的语音,不保留原视频的背景音。
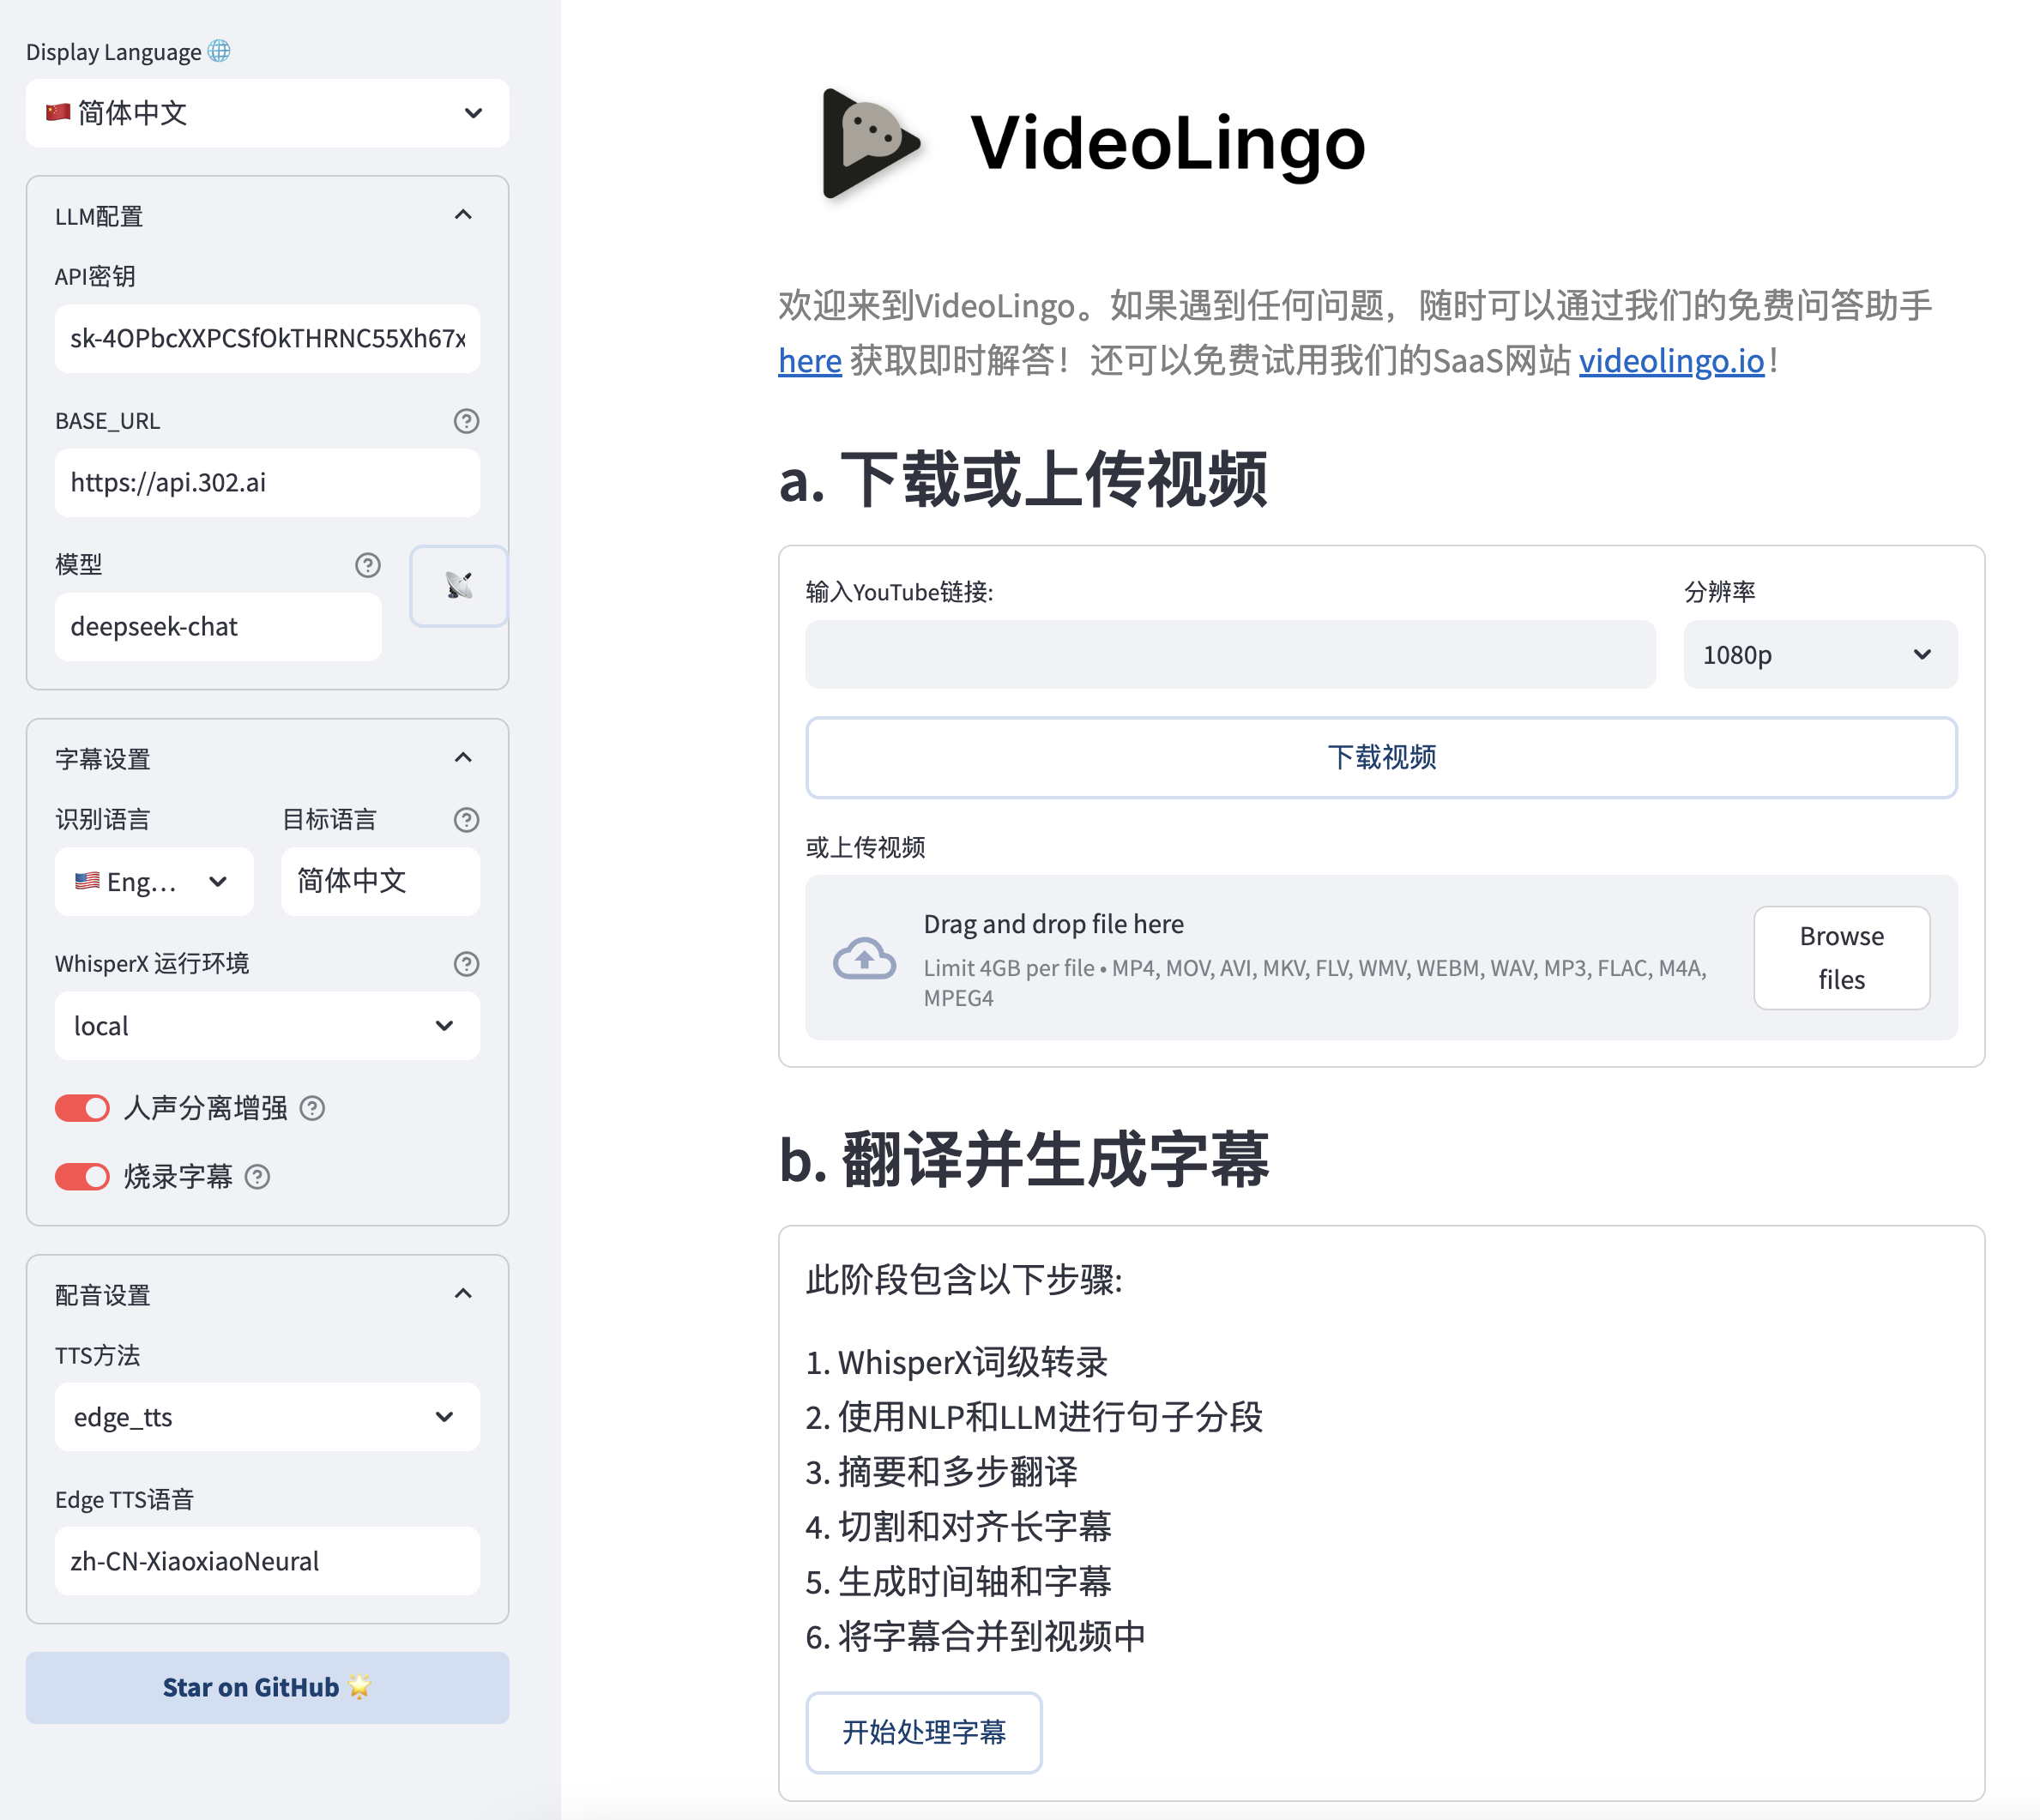
语音识别(Qwen3-ASR + ForcedAligner)
本地识别默认使用 Qwen3-ASR 转写,再用 Qwen3-ForcedAligner-0.6B 生成词级时间轴。开启人声分离时,转写用原始音频,对齐用分离出的人声。
- 模型大小:
config.yaml的whisper.qwen_model(侧栏不提供)。1.7b(默认)更准确;0.6b更快、更省显存。对齐模型固定为 ForcedAligner-0.6B。 - 推理引擎:
whisper.qwen_engine: auto时自动选择,一般不需要改。
| 平台 | 引擎 | 模型 | 说明 |
|---|---|---|---|
| Apple Silicon Mac | MLX(mlx-audio) | mlx-community/Qwen3-ASR-{1.7B,0.6B}-8bit、mlx-community/Qwen3-ForcedAligner-0.6B-8bit | 需要 macOS 14 或更高(mlx 只提供 macOS ≥14 的 arm64 包) |
| Windows / Linux + NVIDIA | 官方 qwen-asr(transformers) | Qwen/Qwen3-ASR-{1.7B,0.6B}、Qwen/Qwen3-ForcedAligner-0.6B | cuda:0,显卡支持 bf16 时用 bf16,否则 fp16 |
| Windows / Linux 无 NVIDIA | 同上 | 同上 | CPU fp32,可以运行但很慢,建议选 0.6B 或改用 ElevenLabs |
| Intel Mac | 官方 qwen-asr(transformers) | Qwen/Qwen3-ASR-{1.7B,0.6B}、Qwen/Qwen3-ForcedAligner-0.6B | CPU fp32,自动安装 PyTorch 2.2.2;识别较慢,建议选 0.6B。可选的人声分离暂不自动安装 |
- 在 Apple Silicon 上,默认依赖只安装 mlx-audio,不安装 qwen-asr;要用
qwen_engine: transformers需要另建环境。macOS 低于 14 时安装器会直接报错退出。旧环境里如果装过 WhisperX,重跑installer.py时会先卸载WhisperX 整套依赖(whisperx、torchcodec、faster-whisper、ctranslate2、pyannote-*),它们与 MLX 依赖冲突。 - 模型下载:首次识别时从 Hugging Face 下载,1.7B 加对齐模型共数 GB。可用
HF_ENDPOINT指定镜像。如果_model_cache/<仓库名末段>/config.json存在(例如_model_cache/Qwen3-ASR-1.7B),会直接使用这份本地模型。 - 语言:侧栏「识别语言」中的语言都受支持(Qwen3-ASR 共支持 30 种语言)。选
Auto时,每个约 3 分钟的窗口先取最多 3 段 20 秒的片段检测语言并投票,再以投票结果强制该语言转写整窗(识别时间约增加三分之一);中英混说时以第一语言为准。Auto 检测出侧栏以外的语言(如韩语、越南语、泰语)时,后续断句会自动选用空格或无空格拼接,并使用对应的 spaCy 模型(没有时按标点断句)。 - 异常输出检测:如果某个窗口的结果是同一短语循环重复,或明显少于检测片段听到的内容,会先切成 60 秒的小窗重试;仍然异常时直接报错,提示明确选择识别语言,而不会把残缺的结果交给后续步骤。手动指定语言时,如果某个窗口的文字异常稀少(每秒不到 2 个字母/数字),会额外用 auto 检测几段片段;片段听到的内容远多于转写结果时同样会报错;如果检测片段听出的是另一种语言,会直接报错提示「所选识别语言可能与音频不符,请改用 auto 或切换模型大小」,不会把换了语言的重试结果交给后续步骤。转写文字的书写系统与所选语言明显不符时(例如选了英文或中文却输出韩文,选了日文却几乎没有假名)也会报同样的错误,这个检查只看文字,不增加识别时间,每个窗口转写完就会检查,第一个窗口不符就会停止。静音和纯音乐不会触发报错。
- 已知限制:同为拉丁字母的语言之间选错(例如英文视频选了西班牙语)无法自动检测。模型可能把部分窗口直接翻译成所选语言,而不是按原话转写,结果会半是原文半是译文。请优先使用
Auto,或在处理前确认识别语言设置正确。 - 识别结果缓存区分后端、模型大小和引擎,切换任一项都会重新识别。
- WhisperX 不是安装器选项。若要使用(包括中文 Belle 模型),请自行安装依赖,见 WhisperX(手动安装)。
- 也可以使用官方 Docker 镜像
qwenllm/qwen3-asr单独部署 Qwen3-ASR 服务,但 VideoLingo 目前不直接调用它。
可选的 MAI-Transcribe-2(Azure Speech 或 OpenRouter)
在侧栏选择 ASR Runtime → MAI-Transcribe-2,再选择 Azure Speech 或 OpenRouter。Azure 使用 whisper.mai_api_key 和 whisper.mai_region(例如 eastus、资源终结点,或留空自动检测);OpenRouter 使用单独的密钥输入框 whisper.mai_openrouter_api_key,不需要 Azure 区域。旧配置未设置 whisper.mai_provider 时仍使用 Azure。默认识别方式仍是本地 Qwen3-ASR。
Azure MAI 使用快速转写 API;OpenRouter 使用专用音频转写 API (opens in a new tab) 和 microsoft/mai-transcribe-2 模型。两种方式都请求清理后的文本及词级时间戳。OpenRouter 会将音频拆为约两分钟的片段,以适应处理超时限制。音频会发送到选定的云服务商,可能产生费用。Azure MAI-Transcribe-2 目前为无 SLA 的公开预览;请确认资源区域支持该模型。缓存会区分服务商及 API 版本,但不包含密钥或 Azure 区域。#618 的贡献者评测 (opens in a new tab)比较的是 MAI 与 WhisperX,尚未比较当前默认的 Qwen3-ASR。
GPU 运行库
- 安装与 NVIDIA 显卡兼容的驱动。
nvidia-smi显示的是驱动支持的 CUDA 版本,不是已安装的 Toolkit 版本。 - 主机安装器在驱动报告 >=12.8 时选择 PyTorch
cu128,否则在检测到 NVIDIA 时选择cu126。无法读取支持版本时也回退到 cu126,但这不保证旧驱动一定兼容。没有 NVIDIA 则选择 CPU 包,已有兼容包可能直接复用。 - 默认的 Qwen3-ASR 通过 PyTorch 运行,使用 PyTorch 安装包自带的 CUDA 运行库,不需要另外安装 cuBLAS/cuDNN。自行安装的 WhisperX 需要 CUDA 12 cuBLAS 和 cuDNN 9,见 WhisperX(手动安装)。
安装器选择的是 Python 包,不会安装系统 CUDA Toolkit。支持 CUDA 13 的新驱动不代表本项目需要 CUDA 13 的 Python 包。
HTTP API
Excel 批处理已由本地 HTTP API 替代,与 Streamlit 共用处理流程。参见 API 使用说明 (opens in a new tab)。
🚨 常见报错与踩坑
-
翻译过程的 'All array must be of the same length' 或 'Key Error':
- 原因1:弱模型遵循JSON格式能力较弱导致响应解析错误。
- 原因2:对于敏感内容,LLM可能拒绝翻译。
检查
output/gpt_log/error.json中的resp_content、resp、message。校验失败记录与成功响应缓存分开保存,先确定出错步骤,再考虑清除该步骤的缓存。
-
'Retry Failed', 'SSL', 'Connection', 'Timeout': 通常是网络问题。解决方案:中国大陆用户请切换网络节点重试。
-
Qwen ASR engine '...' needs the 'qwen-asr' package(或mlx-audio):当前缺少识别包。关闭 VideoLingo 后重新启动即可修复:Windows 双击OneKeyStart.bat,源码安装运行uv run start.py。Apple Silicon 上如果手动设置了qwen_engine: transformers,请改回auto。 -
Qwen3-ASR could not detect the language或... is still degenerate after retrying:Auto模式下没能识别出语言,或识别结果退化(循环重复、内容过少)。在侧栏明确选择识别语言后重试,也可以换另一个模型大小。 -
显存不足(CUDA out of memory):在
config.yaml里把whisper.qwen_model改为0.6b;也可以关闭其他占用显卡的程序。 -
macOS 安装时报 mlx 无法解析 / 没有可用的安装包:mlx 只提供 macOS 14 及以上的 Apple Silicon 安装包,请先升级系统。
-
WhisperX 相关报错(
cublas64_12.dll not found、段错误、Weights only load failed、TorchCodec 等):只在选择了 WhisperX 后端时出现,见 WhisperX(手动安装)。 -
spaCy 模型缺失:VideoLingo 首次用到模型时通常会自动下载。检查网络连接,再重试这一步。
-
Torch 组件版本不一致:关闭 VideoLingo 后重新启动即可修复:Windows 双击
OneKeyStart.bat,源码安装运行uv run start.py。Intel Mac 使用 Torch/torchaudio 2.2.2、torchvision 0.17.2;其他平台使用 2.8.0、0.23.0。三者需要匹配。Intel Mac 不会自动安装 Demucs。